Pada akhir Januari 2025, sebuah aplikasi chatbot buatan perusahaan Tiongkok yang nyaris tidak dikenal publik tiba-tiba menjadi aplikasi gratis nomor satu di App Store Amerika Serikat. Di hari yang sama, saham Nvidia anjlok. Aplikasi itu adalah DeepSeek. Artikel ini merangkum tujuh fakta menarik tentangnya, lengkap dengan sumber di bagian akhir agar bisa Anda periksa sendiri. Di beberapa bagian saya juga sengaja menandai mana yang klaim perusahaan dan mana yang sudah diverifikasi pihak lain.
1. Lahir dari sebuah hedge fund
DeepSeek didirikan pada Juli 2023 oleh Liang Wenfeng dan berkantor pusat di Hangzhou. Perusahaan ini didanai oleh High-Flyer, hedge fund kuantitatif yang juga dirintis Liang. Artinya, DeepSeek bukan startup yang bergantung pada modal ventura besar, melainkan lab AI yang tumbuh dari keuntungan perdagangan berbasis algoritma. High-Flyer sendiri sudah lebih dulu membangun superkomputer GPU untuk riset trading sejak 2020, sehingga infrastruktur dan keahliannya sudah ada sebelum DeepSeek berdiri.
2. Arsitektur "pakar bergantian" yang hemat tenaga
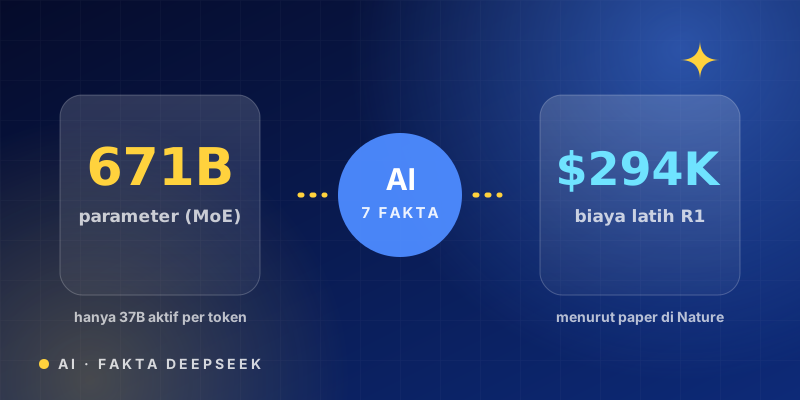
Model DeepSeek-V3 (Desember 2024) memakai arsitektur Mixture-of-Experts (MoE). Totalnya ada 671 miliar parameter, tetapi hanya 37 miliar yang aktif untuk setiap token. Bayangkan rumah sakit dengan banyak dokter spesialis: setiap pasien hanya ditangani beberapa dokter yang relevan, bukan semuanya sekaligus. Hasilnya, model sebesar itu bisa dijalankan dengan biaya komputasi jauh lebih rendah daripada model "padat" berukuran sama.
| Spesifikasi DeepSeek-V3 | Angka (menurut laporan teknis) |
|---|---|
| Total parameter | 671 miliar |
| Parameter aktif per token | 37 miliar |
| Data pelatihan | 14,8 triliun token |
| Waktu komputasi | 2,788 juta jam GPU H800 |
Laporan teknisnya juga menyebut proses pelatihan berjalan "sangat stabil", tanpa lonjakan loss yang tak bisa dipulihkan dan tanpa perlu rollback.
3. Biaya latih "hanya" jutaan dolar, tetapi ada catatannya
Angka yang paling banyak dikutip: dengan asumsi sewa GPU US$2 per jam, 2,788 juta jam GPU setara kira-kira US$5,6 juta (2,788 juta × US$2). Perusahaan sendiri mengatakan modelnya dibuat dalam sekitar dua bulan dengan biaya kurang dari US$6 juta. Namun angka ini hanya biaya komputasi untuk satu putaran pelatihan akhir. Ia tidak mencakup riset, percobaan yang gagal, pengumpulan data, gaji, maupun pembelian perangkat keras. Analis independen, misalnya di Interconnects, mengingatkan agar angka ini tidak dipakai sebagai patokan total biaya membangun model kelas atas. Jadi, "murah" itu benar untuk satu komponen, bukan untuk keseluruhan.
4. Mengguncang bursa: Nvidia kehilangan hampir US$600 miliar dalam sehari
DeepSeek-R1 dirilis pada 20 Januari 2025. Pada 27 Januari, aplikasinya menyalip ChatGPT sebagai aplikasi gratis yang paling banyak diunduh di iOS Amerika Serikat. Pasar bereaksi keras: Nvidia kehilangan hampir US$600 miliar nilai pasar dalam sehari, dan sahamnya sempat turun hingga 18%. Menurut Bloomberg yang dikutip NBC News, itu adalah penurunan nilai pasar satu hari terbesar dalam sejarah pasar saham AS. Logikanya: jika model sekuat itu bisa dilatih dengan komputasi lebih sedikit, apakah dunia masih butuh chip sebanyak yang diperkirakan? Nvidia menanggapi dengan menyebut DeepSeek sebagai "kemajuan AI yang luar biasa". Saham teknologi kemudian pulih sebagian.
5. R1-Zero: belajar bernalar murni lewat reinforcement learning
Keunikan ilmiah terbesar DeepSeek ada pada DeepSeek-R1-Zero. Menurut halaman resminya, model ini dilatih dengan reinforcement learning skala besar tanpa tahap supervised fine-tuning (SFT) di awal. Artinya, model tidak diajari contoh langkah penalaran buatan manusia; ia hanya diberi imbalan ketika jawabannya benar, lalu belajar sendiri cara berpikir bertahap lewat coba-coba. DeepSeek mengklaim ini sebagai penelitian terbuka pertama yang membuktikan kemampuan bernalar LLM dapat ditumbuhkan murni lewat RL. R1 sendiri kemudian menyempurnakan resep itu agar jawabannya lebih rapi dan mudah dibaca.
6. Terbuka berlisensi MIT, dan ada versi "mini" untuk laptop
Bobot model DeepSeek-R1 dilepas dengan lisensi MIT, yang mengizinkan penggunaan komersial, modifikasi, dan distilasi. DeepSeek juga merilis enam model distilled berukuran 1,5B hingga 70B parameter, dibangun di atas model Qwen dan Llama. Versi kecil seperti 7B atau 14B cukup ringan untuk dicoba di komputer pribadi, sehingga pelajar dan pengembang bisa bereksperimen dengan model bernalar tanpa menyewa server mahal.
7. Terbit di Nature, dan mengungkap biaya R1
Pada 17 September 2025, makalah R1 terbit di jurnal Nature. R1 disebut sebagai LLM besar pertama yang melewati proses peer review. Atas masukan para reviewer, DeepSeek mengurangi bahasa yang berlebihan menganggap model seperti manusia dan menambah penjelasan teknis tentang data pelatihan serta keamanan. Materi tambahan makalah itu juga untuk pertama kalinya membuka biaya melatih R1: sekitar US$294.000, terutama memakai chip Nvidia H800. Perlu dicatat, ini hanya biaya pelatihan R1; model dasar yang menjadi fondasinya menelan sekitar US$6 juta secara terpisah.
Bonus: sisi lain yang perlu Anda ketahui
- Privasi. Komisi Perlindungan Informasi Pribadi (PIPC) Korea Selatan menangguhkan unduhan baru aplikasinya mulai 15 Februari 2025 setelah DeepSeek mengakui belum sepenuhnya mempertimbangkan aturan data pribadi setempat; layanan akan dilanjutkan setelah ada perbaikan. Jika Anda mengolah data sensitif, pertimbangkan menjalankan model open-weight secara lokal.
- Terus berkembang. Pada 24 April 2026 DeepSeek merilis pratinjau DeepSeek-V4 dalam dua varian: V4-Pro (1,6 triliun parameter total, 49 miliar aktif) dan V4-Flash (284 miliar total, 13 miliar aktif), keduanya dengan konteks 1 juta token.
- Sikap kritis. Klaim biaya dan performa dari perusahaan mana pun sebaiknya diuji dengan benchmark independen dan kebutuhan Anda sendiri.
Pelajaran bagi pengembang
Dampak terbesar DeepSeek mungkin bukan pada satu model, melainkan pada cara pandang: efisiensi (arsitektur MoE, pelatihan presisi rendah, RL) bisa sama pentingnya dengan skala mentah, dan model terbuka dapat mengejar model tertutup dengan cepat. Bagi kita yang membangun aplikasi, artinya pilihan makin banyak dan biaya inferensi cenderung turun. Namun tetap bijak: baca lisensinya, periksa kebijakan data layanan yang dipakai, dan jangan percaya satu angka tanpa konteks.
Sumber
- arXiv 2412.19437: DeepSeek-V3 Technical Report (671B parameter, 37B aktif, 14,8T token, 2,788 juta jam GPU H800)
- Hugging Face: deepseek-ai/DeepSeek-R1 (lisensi MIT, R1-Zero tanpa SFT, model distilled)
- Scientific American / Nature: Secrets of Chinese AI Model DeepSeek Revealed in Landmark Paper (17 September 2025)
- CTV News (Reuters): China's DeepSeek says its hit AI model cost just US$294,000 to train
- NBC News: Tech stocks react as China's DeepSeek sparks U.S. worries in the AI race (27 Januari 2025)
- Wikipedia: DeepSeek (pendirian Juli 2023, High-Flyer, rilis R1, peringkat App Store)
- Interconnects: DeepSeek V3 and the actual cost of training frontier AI models
- NBC News: South Korea suspends new downloads of DeepSeek, citing privacy concerns (17 Februari 2025)
- DeepSeek API Docs: peluncuran pratinjau DeepSeek-V4 (24 April 2026)
- Wikipedia: High-Flyer
Catatan: angka dan klaim dapat berubah. Artikel ini disusun dari sumber yang tersedia pada Oktober 2026; cek ulang sumber primer sebelum mengutipnya.
Komentar (0)
Masuk / Daftar